El chip propio de OpenAI gasta 700 vatios y se mide con un Nvidia de 1.400
Jalapeño, el acelerador que OpenAI hizo con Broadcom, presume de hasta 1,9 veces más rendimiento por kilovatio que el GB300. La prueba la corrió SemiAnalysis en el laboratorio de OpenAI.
OpenAI llevó a la conferencia Hot Chips los primeros números públicos de su chip propio, y el titular es incómodo para Nvidia: menos vatios, más respuestas.
Qué ha pasado
El chip se llama Jalapeño, lo desarrolló OpenAI junto a Broadcom y es un acelerador de inferencia: no entrena modelos, los ejecuta. Es decir, es la pieza que responde cuando escribes en ChatGPT.
Según las cifras presentadas, Jalapeño entrega entre 1,5 y 1,9 veces más rendimiento por kilovatio y entre 1,7 y 3,6 veces menos latencia de punta a punta que los sistemas GB200 y GB300 de Nvidia. Lo llamativo es de dónde sale esa ventaja: la pieza de OpenAI está declarada a 700 vatios y compite contra aceleradores declarados a 1.200 y 1.400.
Las pruebas se corrieron sobre la batería pública InferenceX de SemiAnalysis con tres modelos abiertos —GPT-OSS 120B, DeepSeek R1 670B y Kimi K2.5, de un billón de parámetros—. OpenAI empezará a desplegarlo en sus propios centros de datos este mismo año.
Las letras pequeñas, que son varias
Conviene leer esos números con la mano en el freno, y el propio Tom's Hardware las enumera:
- La prueba no es independiente del todo. SemiAnalysis reconoce que ejecutó InferenceX junto a ingenieros de OpenAI y en el laboratorio de OpenAI. Su conclusión, eso sí, es rotunda: dice que el chip "supera a todos los de Nvidia, AMD y Google que hemos podido probar".
- Los vatios que se comparan son los del papel, no los medidos. Los resultados se normalizaron al TDP publicado de cada acelerador. OpenAI admite que el consumo sostenido real de Jalapeño se quedó en 550 vatios o menos.
- Con el consumo eléctrico completo, la ventaja se encoge. Un apéndice del propio informe usa el gasto de instalación por acelerador —1,18 kW para Jalapeño frente a 2,55 kW para el GB300— y las distancias se acortan. Lo mismo pasa al enfrentarlo a un GB300 con predicción multitoken, la configuración habitual en producción: ahí el pico de eficiencia baja a alrededor de 1,5 veces.
- No se midió contra Vera Rubin, la plataforma con la que Nvidia va a cubrir el primer gigavatio que OpenAI se comprometió a desplegar en la segunda mitad de 2026.
El cuello de botella se llama memoria
Cada paquete de Jalapeño combina su dado de cómputo con seis pilas de HBM4: 216 GiB a 15,4 TB/s. El GB300 lleva 288 GB de HBM3E con una declaración de 1.400 vatios, así que por vatio nominal el chip de OpenAI carga alrededor de un 50 % más de memoria.
Y esa memoria es hoy lo más escaso de la industria. Samsung, SK hynix y Micron tienen vendida su capacidad de HBM hasta 2027; el consejero delegado de SK hynix ha advertido de que ese será el peor año de la escasez, y Micron explicó en la misma conferencia que la HBM consume unas tres veces más superficie de oblea que la DDR5 para la misma capacidad. Es la raíz de que suban la RAM, los discos y las tarjetas gráficas.
El primer Jalapeño se fabrica, según Tom's Hardware, en un proceso de clase 3 nanómetros de TSMC. Una segunda generación está a punto de cerrar diseño y ya hay trabajo conceptual sobre la tercera.
Independizarse del proveedor al que le debes dinero
La escena tiene un detalle difícil de ignorar. Poco más de una semana antes de estos resultados, Nvidia acordó respaldar hasta 105.000 millones de dólares en financiación para un campus de centros de datos que OpenAI alquilará en Ohio. El propio vicepresidente de hardware de OpenAI, Richard Ho, lo dijo sin rodeos a Bloomberg: "Nvidia es un socio muy bueno y seguimos necesitando mucho de Nvidia".
Qué significa para ti
Ninguno de estos chips se va a vender nunca en una tienda. Aun así te toca por dos vías.
La primera es el precio de la IA que usas. La inferencia es el coste que se repite en cada respuesta, y cuando ese coste baja, baja lo que cuesta ofrecer un plan gratuito o una API. La segunda es más directa: cada acelerador nuevo compite por las mismas obleas y la misma memoria que tu tarjeta gráfica y tus módulos de RAM. Que OpenAI se convierta en un comprador serio de HBM4 no es una buena noticia para lo que vas a pagar por un PC en 2027.
¿Crees que alguien acabará bajándole el trono a Nvidia, o esto es una carrera con un solo caballo?
Fuentes
Sigue leyendo
DLSS 5 ya funciona en las RTX 40 sin permiso de Nvidia, y cuesta un tercio de los fps
La librería se filtró dentro de una versión anticipada de NBA 2K27. Un modder cambió los binarios compilados para Blackwell por otros de Ada y arrancó: en una RTX 4090, los 135 fps se quedan en 82.
La RTX 3060 volvió para abaratar el PC gamer y ya cuesta casi lo mismo que una 5060
Nvidia la resucitó en junio a 339 dólares como salvavidas frente a la crisis de componentes. Dos meses después hay modelos a 480 y 500, y la generación dos escalones más nueva sale mejor.
Tres civiles muertos por un dron que eligió su objetivo solo: dentro llevaba un Nvidia Jetson Orin
Los peritos ucranianos pudieron leer el código de objetivos porque el módulo viajaba sin cifrar. Es el primer caso documentado de muertes civiles con selección totalmente autónoma.
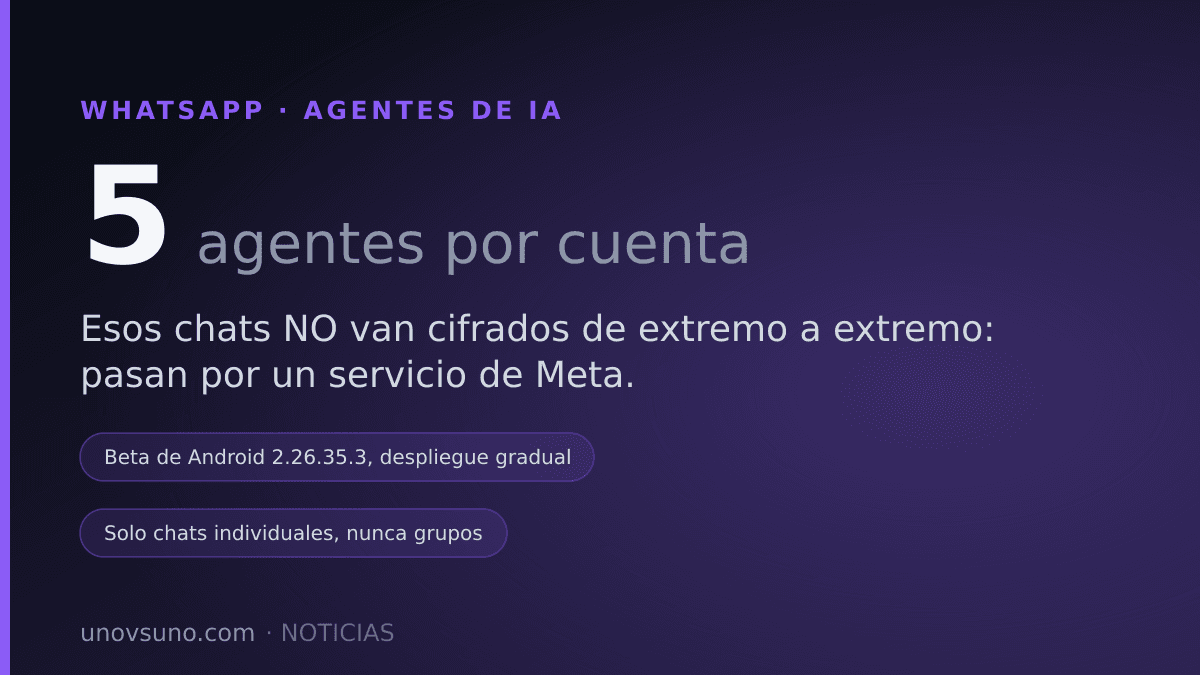
WhatsApp prueba agentes de IA de otras empresas, y esos chats no van cifrados
La beta de Android 2.26.35.3 permite conectar hasta cinco asistentes externos. Los mensajes pasan por un servicio de Meta que puede leerlos: el cifrado de extremo a extremo no aplica ahí.